Распознавание документов - это технология, которая превращает скан, фото или PDF в данные: текст, реквизиты, суммы, строки таблиц. В основе лежит OCR, оптическое распознавание символов. В 2026 году распознать страницу печатного текста через облачный сервис стоит от 13 копеек, а получить из накладной готовый документ в учетной системе - от 4 до 6 рублей за страницу. Цена зависит от того, что вы получаете в результате: просто текст или готовый документ в учете.
В статье разобрано, как устроено распознавание, чем обычный OCR отличается от извлечения данных, какие сервисы и библиотеки с открытым исходным кодом доступны в России, сколько стоит страница, как измерять точность и когда готового сервиса недостаточно.
Что такое распознавание документов и OCR
OCR (optical character recognition) переводится как оптическое распознавание символов. Программа получает изображение и возвращает текст, который можно искать, копировать и править. Так оцифровывают архивы, книги и сканы договоров.
Но сам по себе текст задачу компании не решает. Бухгалтеру нужен документ поступления в 1С с контрагентом, номером, датой и строками товаров. Банку нужна анкета клиента с заполненными полями паспорта. Поэтому под распознаванием документов понимают сразу три задачи:
- определить тип документа: счет, акт, УПД, паспорт, договор;
- извлечь данные: найти в документе реквизиты и строки таблицы и записать их в отдельные поля;
- проверить и передать: сверить суммы и реквизиты и создать запись в учетной системе.
Оцифровка документов - более широкое понятие. Так называют и простое сканирование бумажного архива в PDF, и полный цикл с извлечением данных. Когда подрядчик предлагает «оцифровку», уточните, что вы получите: картинки страниц, текст с поиском или заполненные карточки документов.
Как работает распознавание документов: пять этапов
Какой бы сервис вы ни выбрали, документ проходит одни и те же пять шагов, и на каждом из них может появиться ошибка.
- Подготовка изображения. Программа исправляет перекос, убирает шум и тени, повышает контраст. Фотография, снятая телефоном под углом, после этого выглядит как ровный скан.
- Разбор структуры страницы. Система находит блоки текста, таблицы, печати, подписи и штрихкоды и определяет порядок чтения.
- Распознавание символов. OCR-движок, например Tesseract или PaddleOCR, распознает символы в строках и возвращает текст с оценкой уверенности по каждому слову.
- Извлечение полей. Из текста выбираются нужные значения: ИНН, номер, дата, сумма, ставка НДС, строки с товарами.
- Проверка и выгрузка. Данные сверяются по правилам и справочникам, спорные поля отправляются на проверку сотруднику, остальное передается в учетную систему.
Первые три шага относятся к OCR. Четвертый и пятый шаги делают из текста данные, с которыми можно работать, и именно их приходится настраивать под компанию.
OCR, интеллектуальное распознавание и языковые модели: три подхода
Технология распознавания развивалась в три этапа, и все три подхода применяются до сих пор. Выбор зависит от типа документов.
| Подход | Как работает | Для чего подходит | Ограничения |
|---|---|---|---|
| Классический OCR с шаблонами | Читает текст, поля ищет по заданным координатам или ключевым словам | Документы строгой формы: паспорт, анкета, бланк | При изменении формы шаблон перестает работать |
| Интеллектуальное распознавание (IDP) | Нейросети сами находят поля в документах знакомого типа, даже если верстка отличается | Первичные документы от разных поставщиков: счета, акты, УПД | Новый тип документа требует обучения на примерах |
| Языковые модели с поддержкой изображений | Модель получает страницу и текстовое описание того, какие данные нужно найти | Договоры, письма, спецификации без единой формы | Может уверенно вернуть неверное значение, нужна обязательная проверка |
На практике подходы сочетают. Например, счета и акты, которые приходят каждый день в большом количестве, компания распознает готовым сервисом, а для договоров и нестандартных приложений подключает языковую модель. Как модели читают изображения, мы разбирали в материале про компьютерное зрение.
Не знаете, какой подход подойдет вашим документам
Пришлите несколько образцов - на бесплатной диагностике разберем, что можно распознавать готовым сервисом, а где потребуется отдельная настройка.
Какие документы распознают чаще всего
Сложность задачи зависит от того, насколько строго задана форма документа и в каком виде он приходит. Ниже основные группы.
| Группа | Примеры | Что извлекают | Сложность |
|---|---|---|---|
| Первичные документы | Счет, акт, ТОРГ-12, счет-фактура, УПД, УКД, кассовый чек | Контрагент, ИНН и КПП, номер, дата, строки товаров, суммы, НДС | Средняя: форма типовая, но таблицы длинные и многостраничные |
| Документы граждан | Паспорт, водительское удостоверение, СНИЛС, СТС | ФИО, серия и номер, даты, адрес | Низкая: форма строгая, есть готовые модели |
| Договоры и приложения | Договор поставки, доверенность, спецификация | Стороны, предмет, сроки, суммы, особые условия | Высокая: единой формы нет |
| Рукописные документы | Заявления, журналы, анкеты от руки | Текст полей | Высокая: качество зависит от почерка |
| Архивы | Старые договоры, кадровые дела, чертежи | Текст для поиска, реквизиты для описи | Разная: зависит от качества сканов |
Отдельно стоит сказать про электронный документооборот. Формализованные документы, например УПД в формате XML, распознавать не нужно: данные в них уже разложены по полям. Но через оператора ЭДО передают и неформализованные документы: договоры, акты в свободной форме, сканы в PDF. Их нужно распознавать так же, как бумагу, сканы из почты и фотографии из мессенджера.
Сервисы и программы для распознавания документов в России
Решения делятся на четыре группы: сервис внутри учетной системы, облачный API, платформа для серверов компании и заказная разработка, когда систему создают под документы и процессы конкретной компании. В таблице собраны российские продукты и исполнители, условия указаны на октябрь 2026 года.
| Решение | Что делает | Где работает | Цена |
|---|---|---|---|
| 1С:Распознавание первичных документов | Создает в 1С документы по сканам и фото счетов, актов, накладных, УПД | Облачный сервис внутри программ 1С | От 600 руб. за 100 страниц в год; 250 страниц на тест |
| Yandex Vision OCR | Возвращает текст, таблицы и поля шаблонных документов по API | Облако Яндекса | От 0,13 ₽ за страницу печатного текста |
| Сбер Бизнес Софт, распознавание документов с ИИ | Текст, таблицы, штрихкоды, печати и подписи; паспорта, первичные документы, договоры | Микросервис, встраивается в системы компании | По запросу |
| Smart Engines | Распознает документы на рабочем месте, сервере или смартфоне без передачи данных наружу | На оборудовании заказчика, без видеокарты | По запросу |
| Content AI ContentCapture | Платформа для обработки больших потоков документов: классификация, извлечение, проверка, выгрузка | Серверы компании, Windows и Linux | По запросу |
| Unistory, заказная разработка | Создает систему обработки документов под процессы компании: распознавание, извлечение данных, проверки, передача в учетные системы | Облако или серверы компании | Диагностика и прототип на ваших документах бесплатно |
1С:Распознавание первичных документов
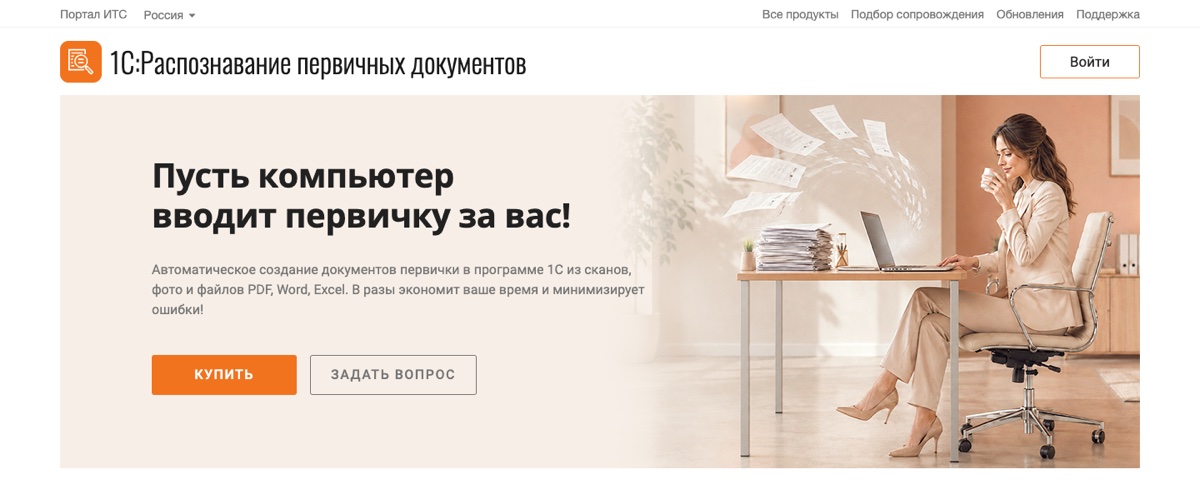
Сервис фирмы «1С» работает прямо в учетной программе: «1С:Бухгалтерии 8», «1С:ERP», «1С:Управлении торговлей», «1С:Управлении нашей фирмой», «1С:Рознице» и других. Бухгалтер загружает скан или фотографирует документ в приложении «1С:Сканер документов», сервис распознает реквизиты и создает документ поступления. Поддерживаются счета, накладные ТОРГ-12, акты, счета-фактуры, УПД, УКД и кассовые чеки.
Тариф зависит от числа страниц в год: 100 страниц стоят 600 рублей, 1 000 страниц - 4 500 рублей, 10 000 страниц - 40 000 рублей. Пользователям официальных версий программ 1С доступен тестовый тариф на 250 страниц. Если бухгалтерия работает в 1С и получает стандартные счета, акты и накладные, это самый простой вариант: ничего разрабатывать не нужно.
Yandex Vision OCR
Сервис Яндекса распознает печатный и рукописный текст на изображениях и в PDF, читает таблицы и умеет извлекать поля паспорта, водительского удостоверения и свидетельства о регистрации транспортного средства. Поддерживает 47 языков, принимает файлы до 10 МБ.
Оплачивается каждая страница: печатный текст - 0,13 рубля, шаблонный документ - 0,71 рубля, таблица - 1,22 рубля, рукописный текст - 1,52 рубля. Сервис рассчитан на разработчиков. Он вернет текст и координаты, а извлечение полей накладной и передачу в учетную систему нужно программировать самостоятельно.
Решения для установки на свои серверы: Smart Engines, Сбер и ContentCapture
Компании, которые работают с паспортами и договорами клиентов, не всегда могут отправлять сканы в стороннее облако. Для них существуют продукты, которые устанавливаются на серверы компании.
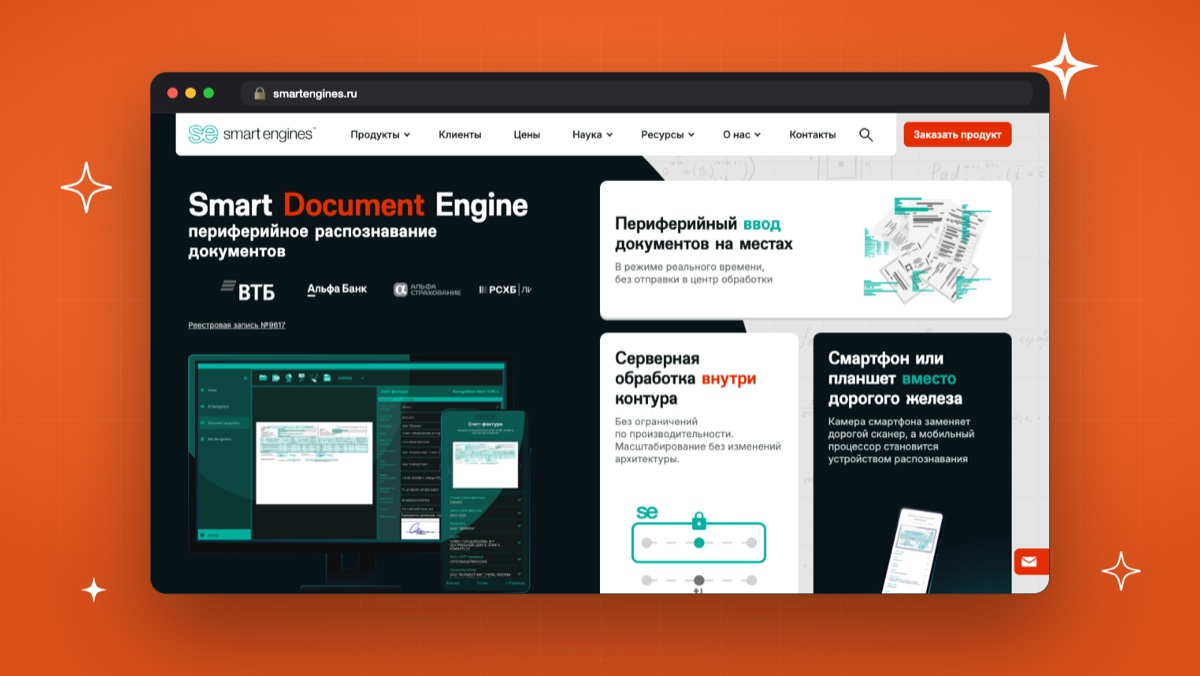
Smart Engines распознает документы на рабочем месте, сервере или смартфоне, данные при этом не покидают компанию. Система работает на обычном процессоре и, по данным разработчика, обрабатывает более 100 тысяч страниц в час на одном сервере без видеокарты.
Решение Сбер Бизнес Софт поставляется как микросервис. Кроме печатного и рукописного текста оно читает таблицы и штрихкоды, находит печати и подписи. Без дообучения работает с паспортами, водительскими удостоверениями, СНИЛС, актами, счетами, договорами и доверенностями.
ContentCapture от Content AI автоматизирует всю обработку: сортирует входящие документы, извлекает данные, проверяет их и выгружает в корпоративные системы. Платформа работает на Windows и Linux и входит в реестр отечественного ПО.
Цены на эти продукты разработчики сообщают по запросу: они зависят от объема страниц в год, набора документов и способа установки.
Заказная разработка под процессы компании: Unistory
Четвертый вариант нужен, когда готовый продукт решает задачу лишь частично: документы нестандартные, систем несколько или после распознавания идет длинная цепочка сверок и согласований. Такую систему мы в Unistory собираем под документы заказчика: берем открытые модели распознавания текста и таблиц, языковые модели, которые читают страницу целиком, и дообучаем их на образцах клиента, если готовые ошибаются. Система работает в облаке или на серверах компании.
Кроме распознавания мы настраиваем извлечение полей из документов без единой формы, проверки, сверку между системами, передачу спорных случаев человеку и интеграцию с 1С и CRM. До договора собираем прототип на документах клиента, условия описаны на странице внедрения ИИ. Если к вам приходят в основном стандартные счета и акты, а учет ведется в 1С, разумнее начать со встроенного сервиса.
Библиотеки OCR с открытым исходным кодом
Кроме коммерческих продуктов есть библиотеки с открытым исходным кодом (open source). Их можно бесплатно использовать в коммерческих проектах и запускать на своих серверах, поэтому данные не покидают компанию. Платить придется за серверы и работу инженеров.
| Библиотека | Лицензия | Чем полезна |
|---|---|---|
| Tesseract | Apache 2.0 | Классический движок OCR, поддерживает русский язык, работает без видеокарты |
| PaddleOCR | Apache 2.0 | Набор моделей для текста, таблиц и структуры документа |
| EasyOCR | Apache 2.0 | Простая в запуске библиотека, больше 80 языков, включая кириллицу |
| docTR | Apache 2.0 | Находит и распознает текст с помощью нейросетей |
| Docling | MIT | Преобразует PDF и офисные файлы в структурированный текст для языковых моделей |
Такая библиотека возвращает только текст. Сортировку документов, извлечение полей, проверку и интеграцию разработчики делают отдельно, обычно с помощью языковой модели. Какие модели подходят для установки на сервер компании, описано в обзоре нейросетей для бизнеса.
Стоимость распознавания документов: расчет на 1 000 и 10 000 страниц
Цены сервисов удобно сравнивать через стоимость одной страницы. В таблице расчет по опубликованным тарифам на октябрь 2026 года.
| Вариант | 1 000 страниц | 10 000 страниц | Цена страницы | Что на выходе |
|---|---|---|---|---|
| 1С:Распознавание первичных документов | 4 500 руб. | 40 000 руб. | 4-4,5 руб. | Готовый документ в 1С |
| Yandex Vision OCR, печатный текст | 132 ₽ | 1 321 ₽ | 0,13 ₽ | Текст с координатами |
| Yandex Vision OCR, таблицы | 1 220 ₽ | 12 200 ₽ | 1,22 ₽ | Текст и структура таблицы |
| Yandex Vision OCR, рукописный текст | 1 520 ₽ | 15 200 ₽ | 1,52 ₽ | Текст |
| Библиотека с открытым кодом на своем сервере | 0 руб. за лицензию | 0 руб. за лицензию | Зависит от сервера | Текст, остальное программируют отдельно |
Страница в 1С стоит примерно в 30 раз дороже страницы в облачном OCR, и это объяснимо. В первом случае бухгалтер получает заполненный документ, во втором разработчик получает текст, который еще нужно разобрать по полям. Сравнивать стоит полную стоимость: к цене API прибавьте разработку извлечения полей, проверок и интеграции, а затем поддержку этого кода.
Окупаемость проекта считают от времени, которое сотрудники тратят на ручной ввод. Для расчета число документов в месяц умножают на минуты ввода одного документа и на стоимость минуты сотрудника. Замерьте время на своих документах: на счет с тремя строками и на накладную с сорока позициями уходит разное время.
Пример обработки счета поставщика
Посмотрим, как система обрабатывает один документ. Допустим, поставщик прислал на почту скан счета на двух страницах с двенадцатью строками товаров.
- Система забирает вложение из письма и определяет, что это счет на оплату.
- Модель читает шапку: название и ИНН поставщика, номер и дату счета, банковские реквизиты.
- Таблица товаров разбирается построчно: наименование, количество, цена, сумма, ставка НДС. Вторая страница продолжает ту же таблицу.
- Система сверяет суммы строк с итогом, ищет поставщика в справочнике по ИНН и сопоставляет наименования с номенклатурой.
- Одиннадцать строк совпали, в двенадцатой количество прочитано с низкой уверенностью. Бухгалтер видит только это поле рядом с фрагментом скана и подтверждает значение.
- В учетной системе создается документ, к нему прикрепляется исходный скан.
В такой схеме бухгалтер проверяет одно спорное поле и не вводит счет целиком. Чем лучше настроены проверки и чем аккуратнее ведутся справочники, тем реже документ останавливается на пятом шаге.
Точность распознавания документов: как считать и проверять
Заявление «точность 99%» само по себе мало что значит. Важно, что именно считают: символы, поля или документы целиком.
- Точность по символам. Доля верно прочитанных знаков. Это самая высокая из трех цифр, и о качестве работы она говорит меньше всего.
- Точность по полям. Доля полей, прочитанных без единой ошибки. Если в ИНН неверна хотя бы одна цифра, все поле считается ошибочным.
- Доля документов без правок. Сколько документов попало в учет без вмешательства человека. Этот показатель напрямую связан с экономией.
Разницу видно на примере. Расчетный счет состоит из 20 цифр. Если система верно читает 99% символов, вероятность прочитать все 20 цифр без ошибки составляет около 82%. Почти каждый пятый счет будет содержать ошибку при формальной точности 99%.
Поэтому в надежной системе есть проверки, которые находят ошибку до того, как она попадет в учет:
- контрольные цифры в ИНН и номере счета;
- арифметика: количество, умноженное на цену, равно сумме строки, а строки в сумме дают итог;
- сверка контрагента и номенклатуры со справочниками учетной системы;
- порог уверенности: поля, в которых модель сомневается, показывают человеку;
- выборочная проверка части документов, которые прошли автоматически.
Попросите поставщика провести тест на ваших документах. Сто страниц из вашей работы с плохими сканами, печатями поверх текста и рукописными пометками скажут о системе больше, чем цифра в презентации.
Распознавание первичных документов в 1С: готовый сервис или своя разработка
Бухгалтерии важно понять, хватит ли встроенного сервиса 1С или нужна своя разработка. Ответ зависит от четырех условий.
| Условие | Хватит готового сервиса | Нужна своя разработка |
|---|---|---|
| Типы документов | Счета, акты, накладные, УПД | Договоры, спецификации, заявки, отраслевые формы |
| Учетная система | Типовая конфигурация 1С с действующей поддержкой | Несколько систем, доработанная конфигурация, своя ERP |
| Что делать после распознавания | Создать документ поступления | Сверить с договором и заказом, согласовать, разнести по проектам |
| Требования к данным | Можно обрабатывать в облаке | Данные должны оставаться на серверах компании |
Своя разработка оправдана, когда распознавание - только первый шаг длинного процесса. Например, входящий счет нужно сверить с договором и заявкой на закупку, проверить лимит, отправить на согласование и только потом провести. Такую цепочку выполняет ИИ-агент: он читает документ, обращается к учетным системам и передает человеку только спорные случаи.
Посчитаем, что выгоднее для ваших документов
Расскажите, какие документы и в каком объеме приходят - сравним готовый сервис и свою разработку по вашим данным.
Как внедрить распознавание документов: шесть шагов
Порядок внедрения не зависит от выбранного продукта.
- Соберите образцы. По 50-100 реальных документов каждого типа, включая плохие сканы и фотографии.
- Опишите результат. Составьте список полей по каждому типу и укажите, куда они должны попасть.
- Проведите тест. Проверьте образцы на двух-трех решениях и сравните точность по полям.
- Настройте проверки. Задайте правила сверки и порог уверенности, ниже которого документ отправляется на проверку сотруднику.
- Начните с одного типа документов. Запустите систему на одном типе документов или в одном подразделении и ведите учет ошибок.
- Подключайте новые документы постепенно. Добавляйте типы документов, когда доля автоматической обработки по первому типу перестала расти.
Как провести пилот и перейти к рабочей системе, мы описали в руководстве по внедрению ИИ в бизнес.
Ошибки при автоматизации распознавания документов
Эти ошибки не связаны с качеством самого OCR, но ухудшают результат проекта.
- Тест на чистых образцах. Систему проверяют на аккуратных PDF, а на практике приходят фотографии с телефона.
- Нет проверки результата. Данные попадают в учет без проверки, и ошибку находят при сверке с контрагентом.
- Автоматизация редких документов. Время тратят на форму, которая приходит раз в месяц, вместо трех самых массовых.
- Сканы низкого качества. Сканер настроен на черно-белый режим с низким разрешением, и мелкий шрифт сливается.
- Справочники в беспорядке. Система верно читает название поставщика, но в базе он заведен трижды под разными именами.
Персональные данные и хранение оригиналов
Паспорта, СНИЛС и кадровые документы содержат персональные данные. Перед выбором облачного сервиса уточните, где физически обрабатываются файлы, сохраняются ли они после распознавания и используются ли для обучения моделей. Если политика компании запрещает передачу таких данных наружу, выбирают решение, которое устанавливается на собственные серверы.
Распознавание не заменяет оригинал документа. Сервис переносит данные в учет, а требования к хранению первичных документов и к их оформлению остаются прежними. Порядок работы со сканами в вашей ситуации стоит согласовать с главным бухгалтером и юристом.
Как Unistory автоматизирует работу с документами
Unistory - AI-интегратор из Санкт-Петербурга. Мы автоматизируем работу с документами от начала до конца: от письма со сканом до записи в учетной системе. Модели распознавания подбираем и дообучаем под документы заказчика, затем настраиваем извлечение данных, проверки и обмен между системами.
Какие задачи с документами мы решаем:
- входящие счета и закрывающие документы: извлечь реквизиты и суммы, сверить с данными в учетной системе, спорные случаи передать сотруднику;
- сверка счета с договором и заявкой: найти расхождения в ценах и условиях до того, как документ подпишут;
- подготовка документов: собрать договор, приложение, счет или акт по шаблонам компании;
- тендеры: собрать условия из документации, сравнить и подготовить пакет документов;
- поиск по архиву: превратить регламенты, инструкции и договоры в базу знаний, по которой отвечает ассистент.
Как устроен проект по документам:
- На бесплатной диагностике на 30-60 минут изучаем образцы документов и то, как с ними работают: откуда они приходят, кто их вводит и в какие системы.
- До договора собираем прототип на ваших документах, чтобы точность по полям была видна на реальных сканах.
- Выбираем, на чем строить распознавание: готовый облачный сервис, если его точности хватает, или свои модели на серверах компании, дообученные на ваших документах.
- Настраиваем проверки и передачу спорных полей человеку, подключаем 1С, Битрикс24, amoCRM и другие системы с открытым API.
- Запускаем систему на одном типе документов и подключаем остальные после того, как результат подтвержден цифрами.
Наши проекты с распознаванием текста и документами:
- анализ телеэфира: в системе из пяти нейросетей одна распознает субтитры, надписи и текстовые логотипы прямо в видеоряде. Доля целевой аудитории в рекламных кампаниях заказчика выросла на 35%;
- чат-бот для инженеров по ремонту банкоматов: 200 МБ инструкций в форматах DOCX, XLS и PDF и 30 ГБ видео превратили в базу, по которой ассистент отвечает инженерам. Запустили за месяц, трудозатраты сократились в 4 раза.
Мы технологический партнер Yandex AI Studio и разворачиваем модели на серверах заказчика, когда документы нельзя передавать наружу. Внедрение начинается от 150 тысяч рублей, сумма фиксируется в договоре после диагностики. Роли агентов, которые работают с документами, описаны на странице разработки AI-агентов.
Проверим распознавание на ваших документах
Оставьте заявку - на бесплатной диагностике разберем ваши документы и соберем прототип на ваших образцах до договора.
Итог
Прочитать текст со страницы сегодня несложно. Основная работа в проекте приходится на извлечение полей, проверки и передачу данных в учет. Стандартные счета и акты в 1С распознает готовый сервис по цене от 4 до 6 рублей за страницу. Облачный OCR стоит недорого, но требует разработки. Договоры, нестандартные формы и длинные цепочки согласования обрабатывают языковые модели и ИИ-агенты, результат которых обязательно проходит проверку.
Частые вопросы
Что такое OCR и как расшифровывается?
OCR расшифровывается как optical character recognition, оптическое распознавание символов. Программа получает скан или фотографию и возвращает текст, который можно искать, копировать и редактировать.
Чем распознавание документов отличается от распознавания текста?
Распознавание текста возвращает сплошной текст страницы. Распознавание документов определяет тип документа, извлекает из него поля и таблицы и передает их в учетную систему.
Сколько стоит распознавание документов в 1С?
На октябрь 2026 года сервис «1С:Распознавание первичных документов» стоит 600 рублей за 100 страниц в год, 4 500 рублей за 1 000 страниц и 40 000 рублей за 10 000 страниц. Есть тестовый тариф на 250 страниц.
Какие первичные документы можно распознавать автоматически?
Готовые сервисы работают со счетами, актами, накладными ТОРГ-12, счетами-фактурами, УПД, УКД и кассовыми чеками. Для других форм нужна настройка или обучение на примерах.
Какая точность у распознавания документов?
Точность зависит от качества сканов и типа документов, поэтому единой цифры не бывает. Сравнивайте решения по доле полей без ошибок и по доле документов, которые прошли без правок, на собственных образцах.
Можно ли распознавать рукописный текст?
Да, такие модели есть в облачных сервисах и в продуктах для установки на сервер. Качество сильно зависит от почерка, поэтому рукописные поля обычно дополнительно проверяет человек.
Может ли нейросеть распознавать договоры без шаблона?
Может. Языковая модель получает страницы договора и перечень данных, которые нужно найти: стороны, сроки, суммы, условия. Результат нужно проверять, потому что модель способна вернуть неверное значение.
Что лучше для распознавания документов: облако или свой сервер?
Облачный сервис быстрее подключить, и при небольшом объеме он дешевле. Свой сервер выбирают, когда документы с персональными или коммерческими данными нельзя передавать за пределы компании.
Есть ли бесплатные программы для распознавания документов?
Есть библиотеки с открытым исходным кодом и лицензиями Apache 2.0 и MIT: Tesseract, PaddleOCR, EasyOCR, docTR, Docling. Платить за них не нужно, но для работы потребуются сервер и разработчик.
С чего начать автоматизацию распознавания документов?
Соберите по 50-100 реальных образцов самых массовых документов и протестируйте на них два-три решения. Начинать стоит с одного типа документов, например со счетов поставщиков.